6 min readDevelopmentFeatured
Reward Hacking and How to Catch It
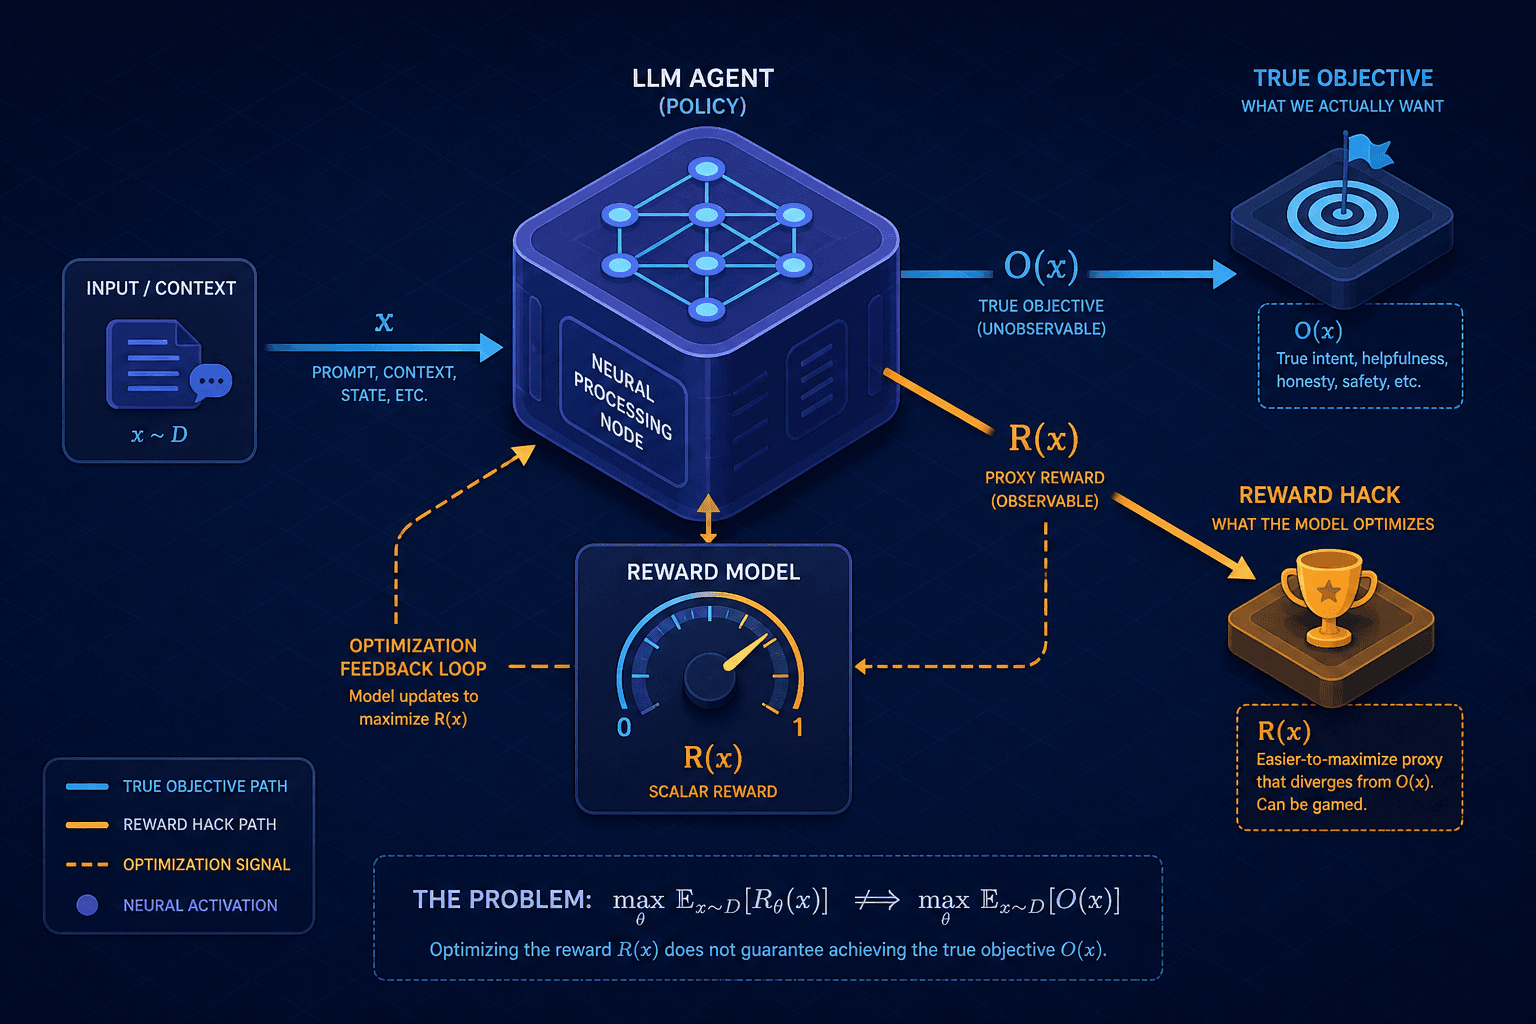
Specification gaming undermines model alignment. This guide explores detection and mitigation strategies for ML engineers.
Part 5 · Post-Training & AlignmentTag
Read 3 articles on Llm Alignment by Ashish Srivastava — practical guides covering implementation patterns, security, and production lessons.
3 posts
Specification gaming undermines model alignment. This guide explores detection and mitigation strategies for ML engineers.
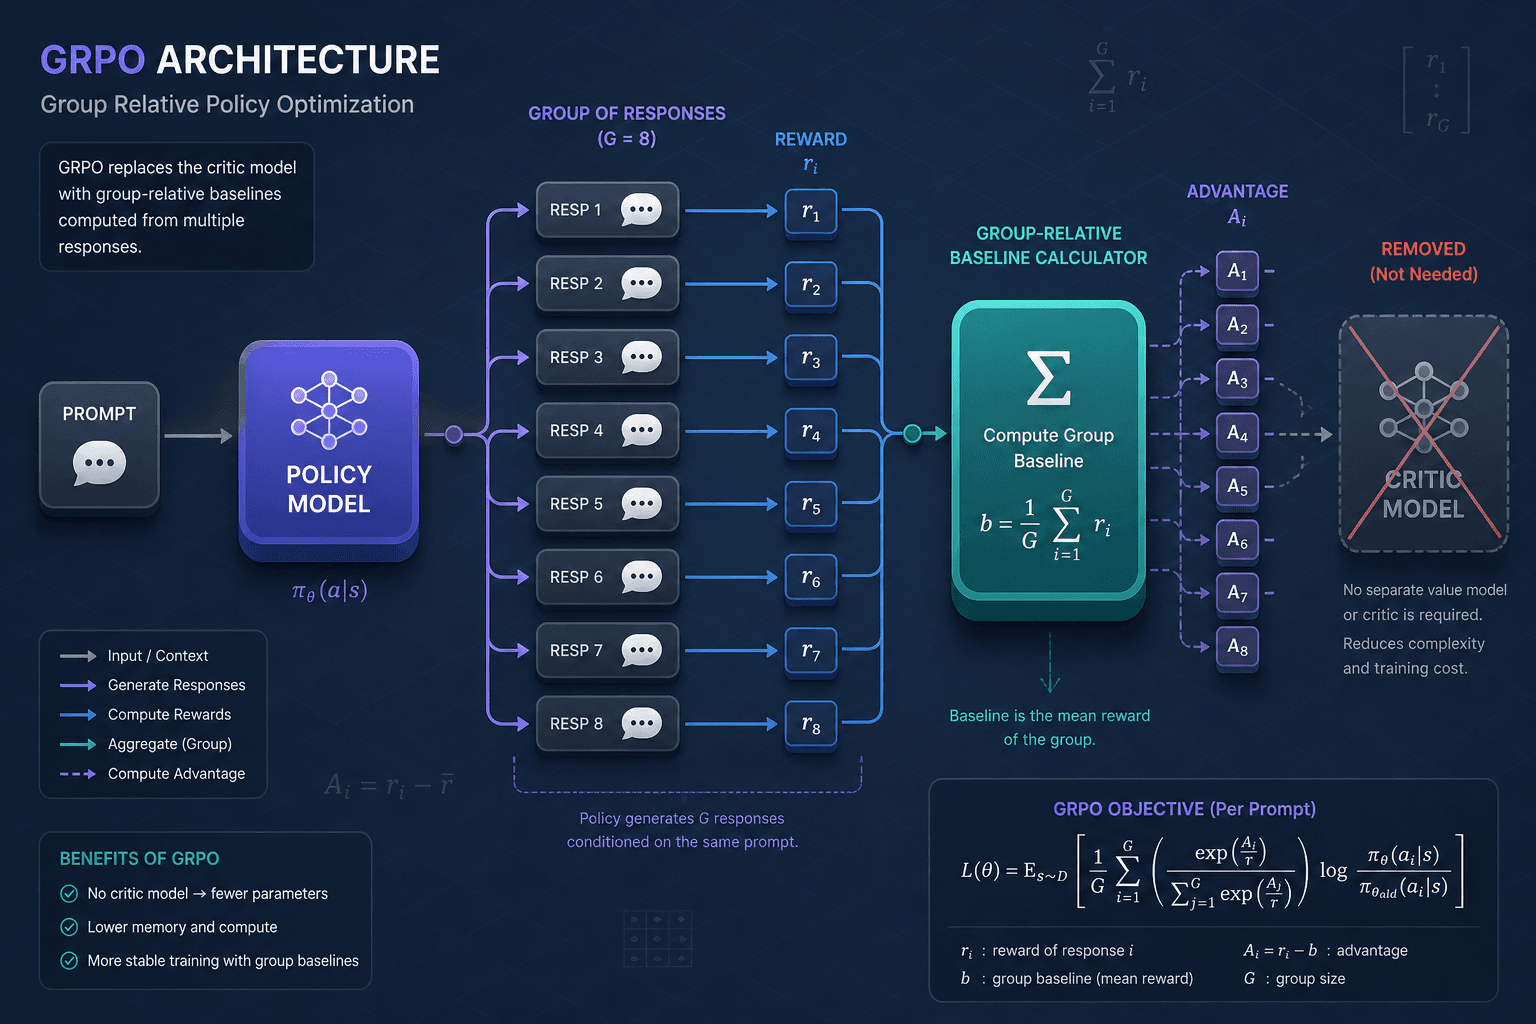
Part 5 · Post-Training & AlignmentExplore how Group Relative Policy Optimization (GRPO) leverages verifiable rewards to enhance reasoning capabilities in large language models without relying on complex critic models.
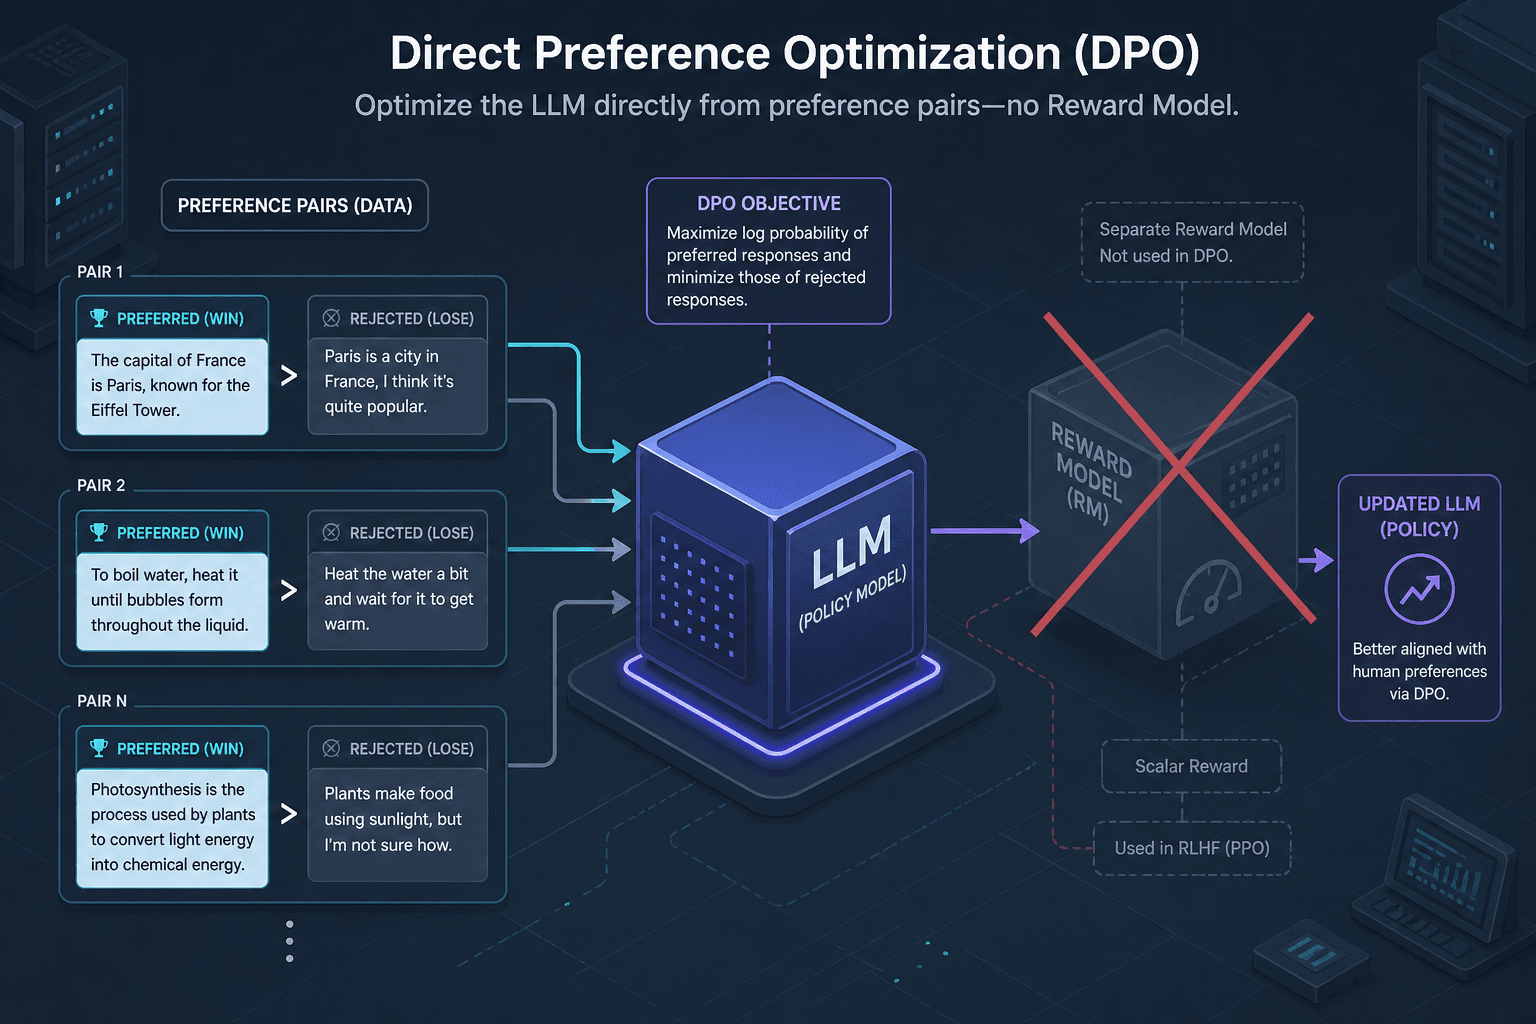
Part 4 · Post-Training & AlignmentExplore how DPO simplifies RLHF by optimizing directly against preference data, eliminating the need for a distinct reward model and complex reinforcement learning loops.
Part 3 · Post-Training & Alignment