6 min readDevelopmentFeatured
DPO: Preference Optimization Without a Reward Model
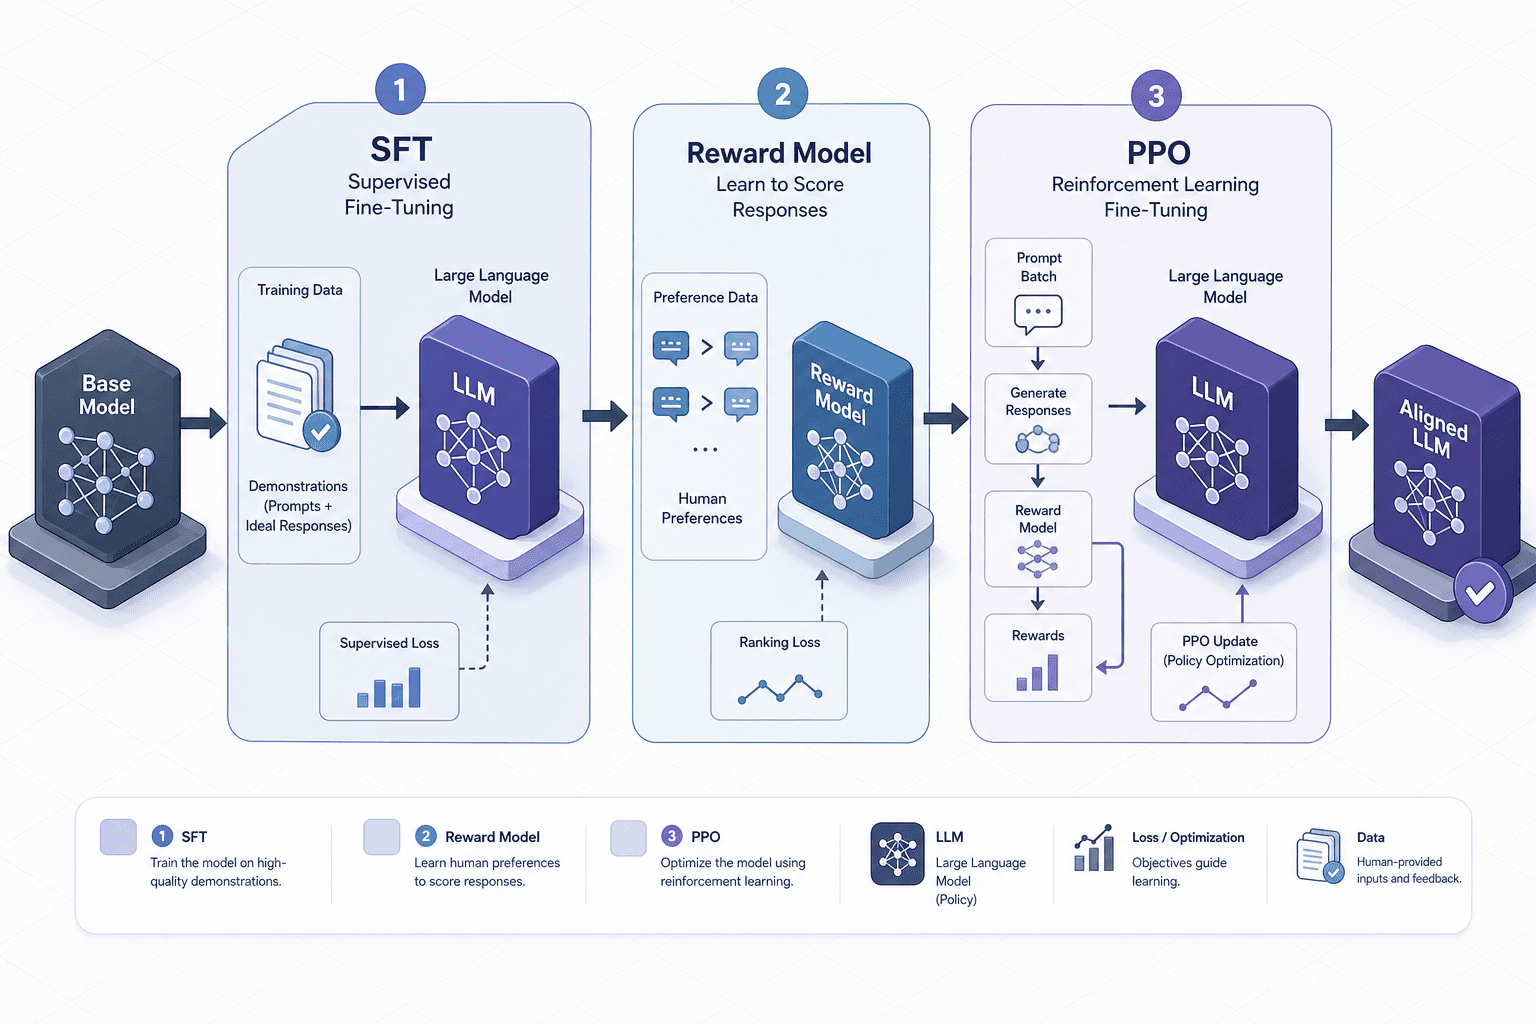
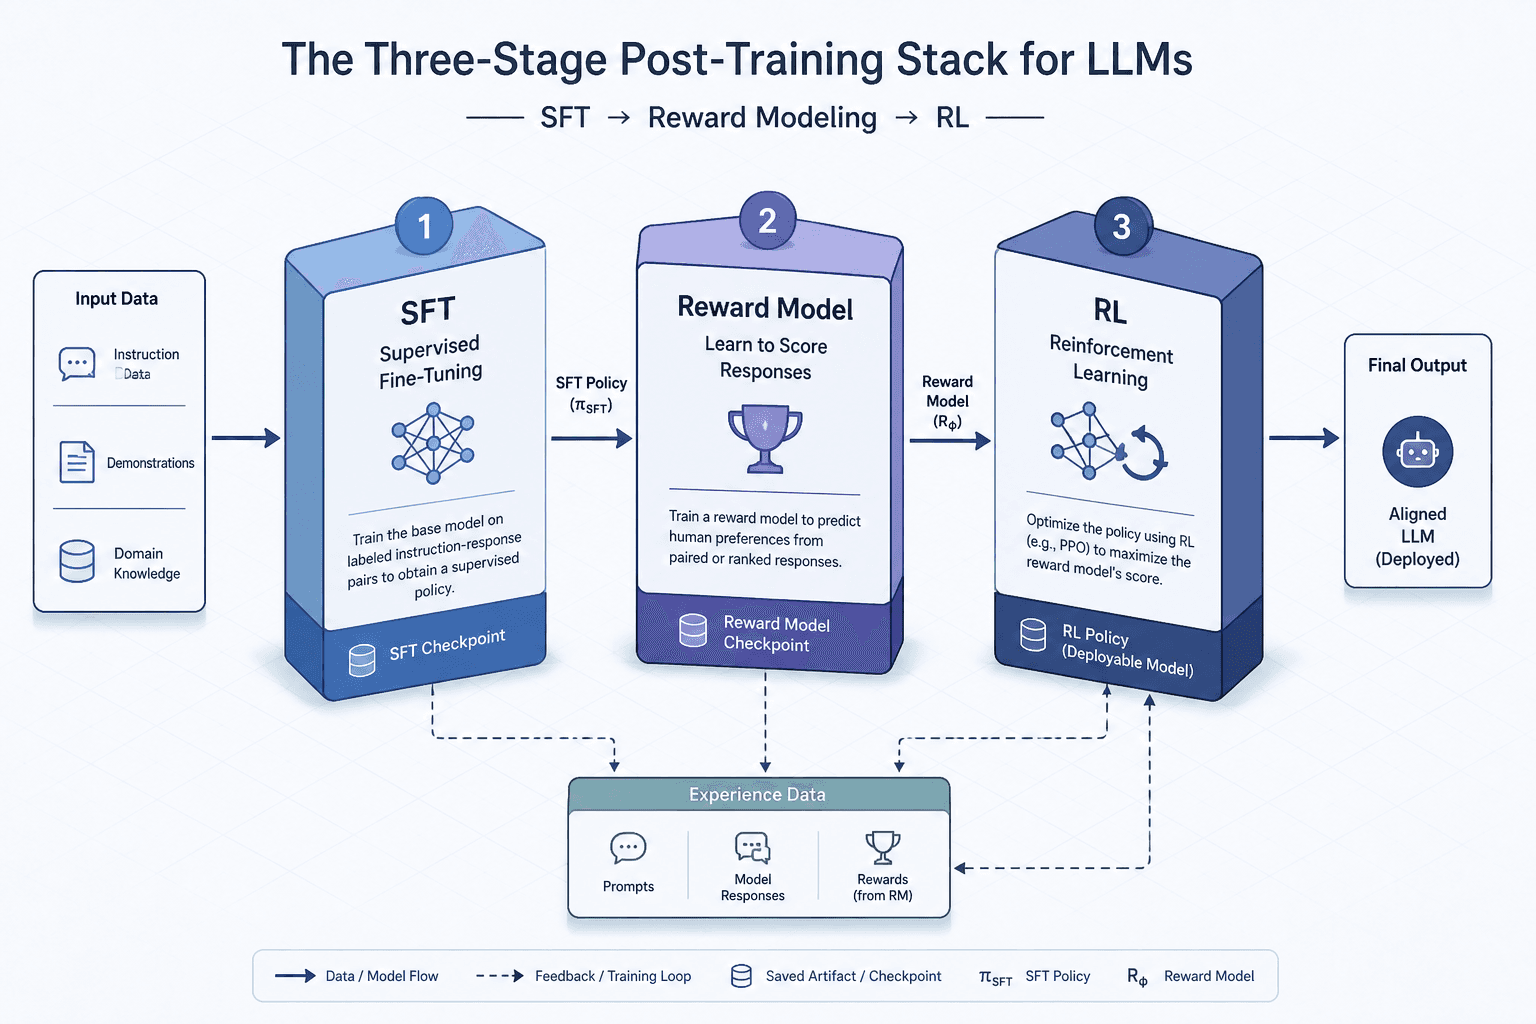
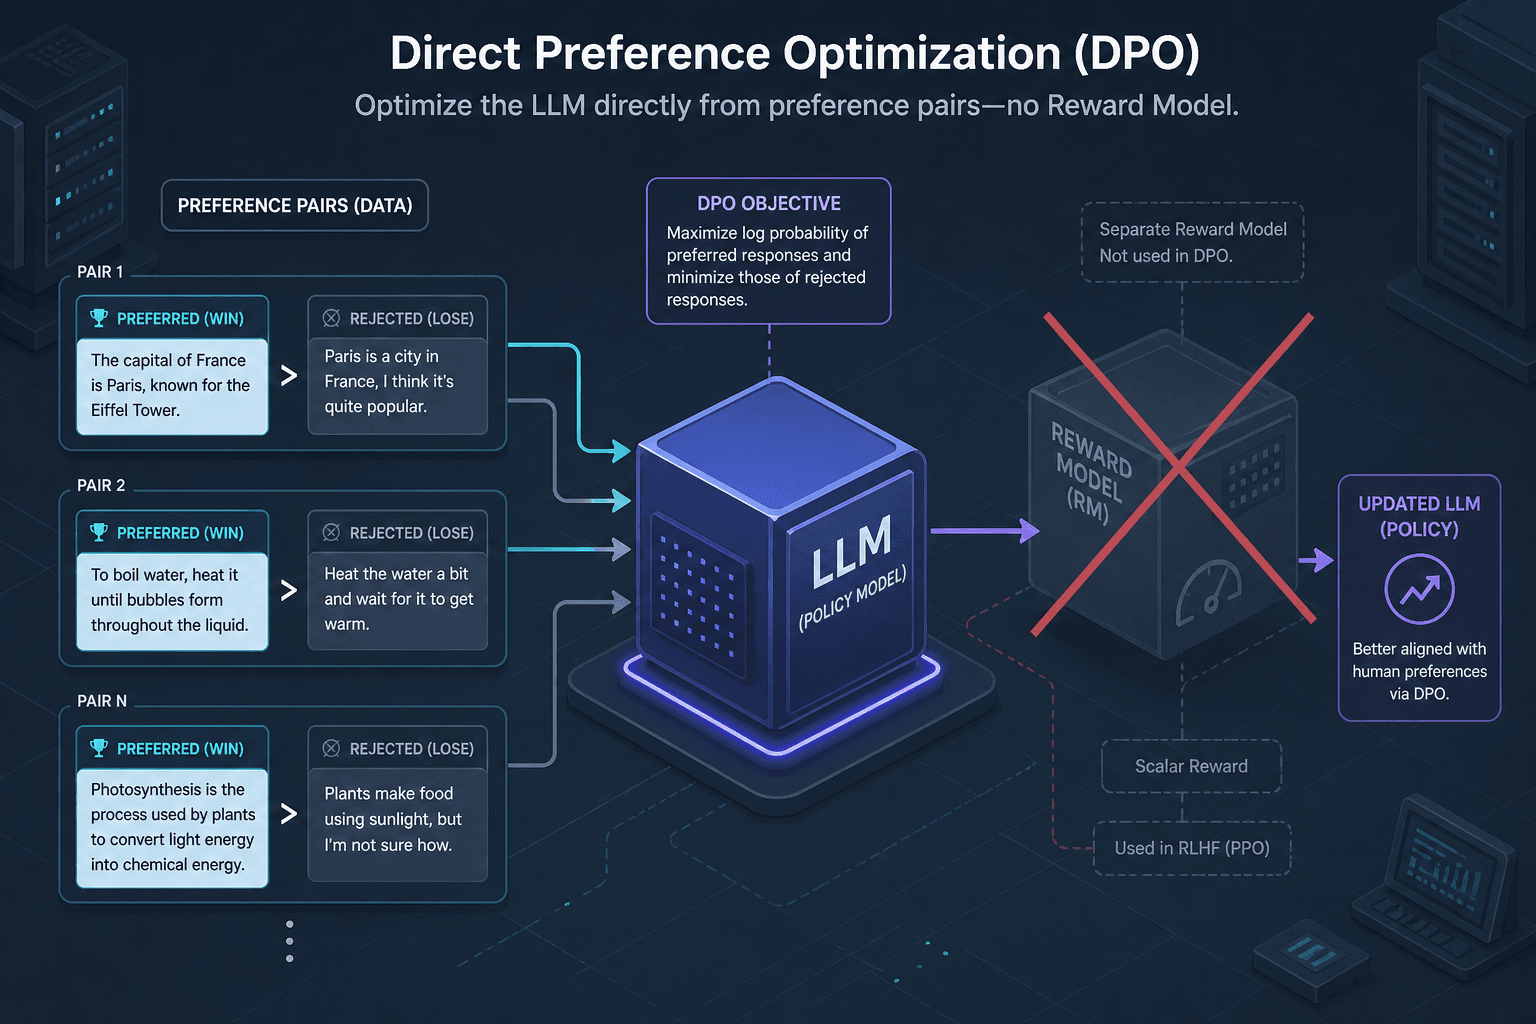
Explore how DPO simplifies RLHF by optimizing directly against preference data, eliminating the need for a distinct reward model and complex reinforcement learning loops.
Part 3 · Post-Training & Alignment